Comparador de preços
Compara o preço de produtos em diferentes supermercados.
Ver produto →Resumo rápido
- Função
- Produto, design e desenvolvimento full-stack (sozinho)
- Período
- Agosto 2026
- Stack técnico
- React + Vite/crxjs + Tailwind (base) → cascata de extração própria (JSON-LD/microdata/DOM) → matching léxico próprio → embeddings semânticos locais (ONNX/WASM)
O problema
A ideia nasceu de uma lembrança: quando meu filho era pequeno, sempre estávamos buscando ofertas de fraldas entre supermercados. Naquele momento teria me ajudado muito ter algo assim — digitar o produto uma única vez e ver imediatamente onde estava mais barato, em vez de abrir aba por aba e repetir a mesma busca em cada loja.
Esse mesmo problema continua atual hoje, com o agravante de que a busca de cada loja nem sempre mostra o que você realmente pediu: quando não têm o produto exato, muitas retornam “produtos similares” em vez de uma lista vazia, e é fácil acabar comparando o preço de algo que nem é o que você procurava.
A decisão de design de fundo foi reduzir a complexidade ao mínimo possível: nada de scraping periódico de catálogos, nada de infraestrutura para manter, nenhum custo repassado ao usuário. Tudo roda no próprio navegador, sob demanda, quando o usuário busca. Não é um projeto pensado para monetizar — é resolver um problema real da forma mais simples e barata possível.
A construção
Nenhuma dessas versões saiu de um planejamento fechado de antemão: cada uma surgiu de testar os resultados reais da busca, encontrar onde a precisão falhava, e ajustar a aplicação com base nisso — não de adicionar funcionalidade por adicionar.
V1 — MVP funcional multi-loja (agosto 2026)
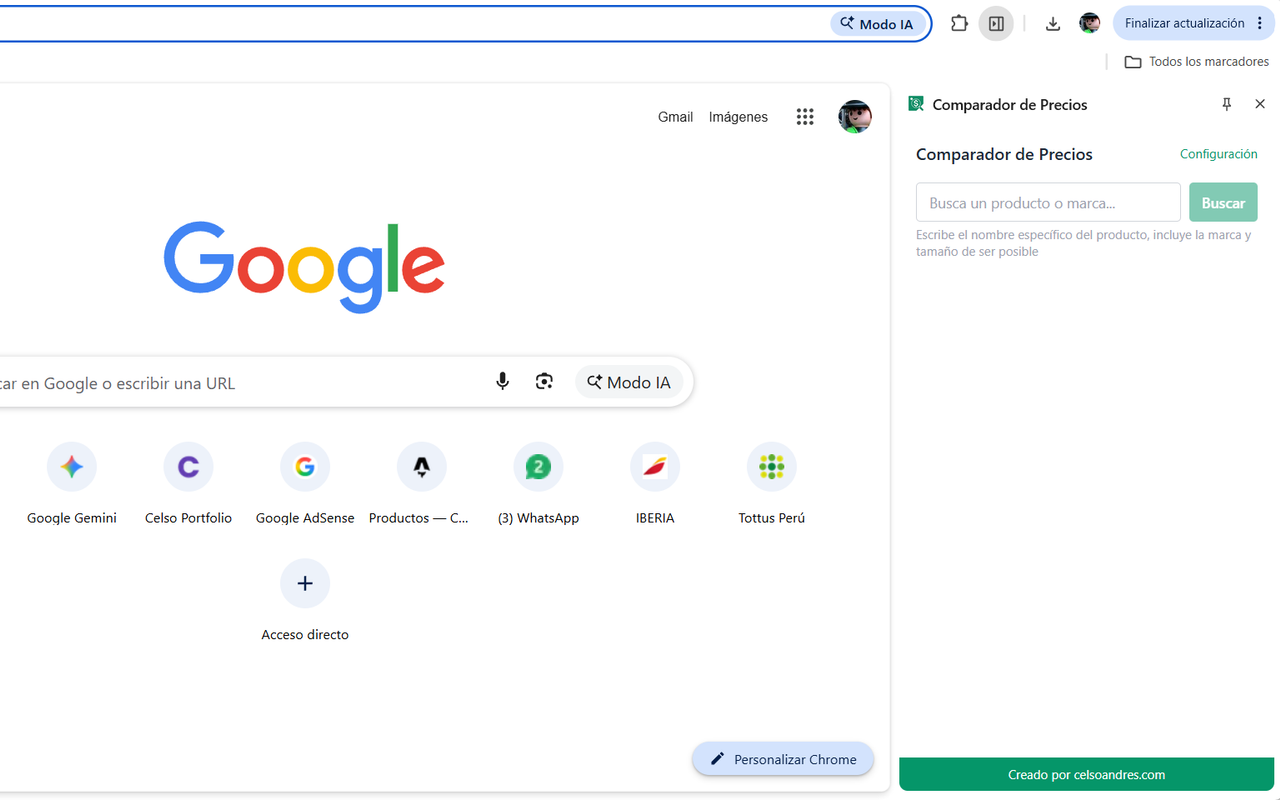
- Manifest V3 completo: service worker em background + interface no side panel do Chrome, sem nenhum servidor próprio.
- Modelo de dados validado com Zod e CRUD de lojas persistido em
chrome.storage.local. - Motor de extração em cascata com pontuação de confiança por estratégia: JSON-LD → microdata → meta tags → heurística de DOM, para cobrir a variedade real de como cada plataforma de e-commerce marca seus produtos.
- Onboarding guiado (idioma, país, até 5 lojas) com permissões de host solicitadas uma por uma, apenas para os sites que o usuário adiciona.
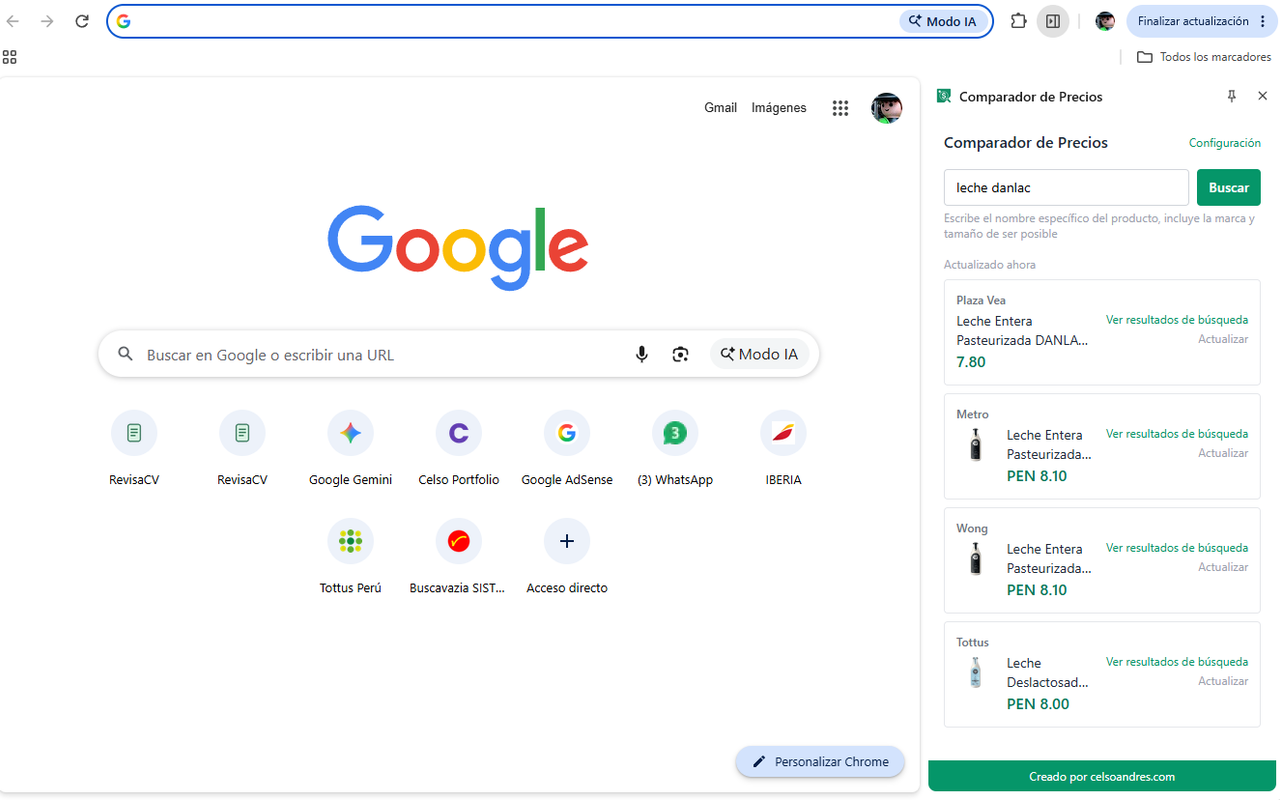
- Orquestração de busca: abre uma aba (ou janela minimizada) por loja, extrai, fecha, e armazena o resultado em cache com um TTL configurável.
- Curadoria manual e verificada ao vivo de lojas sugeridas para 7 países (Peru, Argentina, Chile, Brasil, Paraguai, Colômbia, Equador) — cada URL de busca confirmada navegando na loja real, não presumida.
V2 — Matching de relevância, nível léxico (agosto 2026)
- Gatilho real: uma loja (Wong) retornou um iogurte grego como resultado de uma busca por kefir de uma marca específica — a extensão mostrava o primeiro resultado como se fosse o correto, sem validar se realmente correspondia ao que foi buscado.
- Heurística própria de comparação texto-a-texto: normalização de acentos, tokenização, lista de stopwords em espanhol/português, tolerância a variantes de escrita via distância de Levenshtein (singular/plural, erros de digitação), sinônimos regionais curados (palta/abacate, choclo/milho, etc.), e um sinal de ordem das palavras para desempatar títulos que compartilham as mesmas palavras em ordem diferente.
- Novo estado “não encontrado” (diferente de “erro de extração”), com um link direto para a busca real da loja para que o usuário decida se o match automático não o convence.
V3 — Matching semântico local, nível embeddings (agosto 2026)
- Modelo
multilingual-e5-smallquantizado (ONNX) rodando com@huggingface/transformerssobre WebAssembly, empacotado dentro da própria extensão — zero chamadas a serviços de IA externos, funciona offline. - Projetado como sinal híbrido, não como substituto: o matching léxico continua sendo o filtro principal (forte em nomes de marca, que um modelo de embeddings não distingue bem); o modelo semântico só entra em uma “zona de dúvida” da pontuação léxica, com um limiar bem mais exigente do que o testado inicialmente.
- Ajustes de build não triviais para viabilizar isso: um alias do Vite para evitar empacotar 4 variantes do binário WASM (até 26MB cada, pensadas para WebGPU/compatibilidade com navegadores antigos que não se aplicam aqui), CSP com
wasm-unsafe-eval, e o modelo vendorizado localmente para cumprir a política do Manifest V3 contra “código remoto”.
V4 — Confiança do usuário e publicação (agosto 2026)
- Botão de cancelar durante uma busca em andamento, que interrompe o processo e fecha as abas abertas — com um registro de abas por busca para cobrir o caso em que o Chrome não permite cancelar de verdade uma aba já em abertura.
- Transparência sobre a incerteza do matching: o botão “Ver produto” passou a ser “Ver busca” e leva aos resultados reais da loja, não a um produto específico escolhido automaticamente.
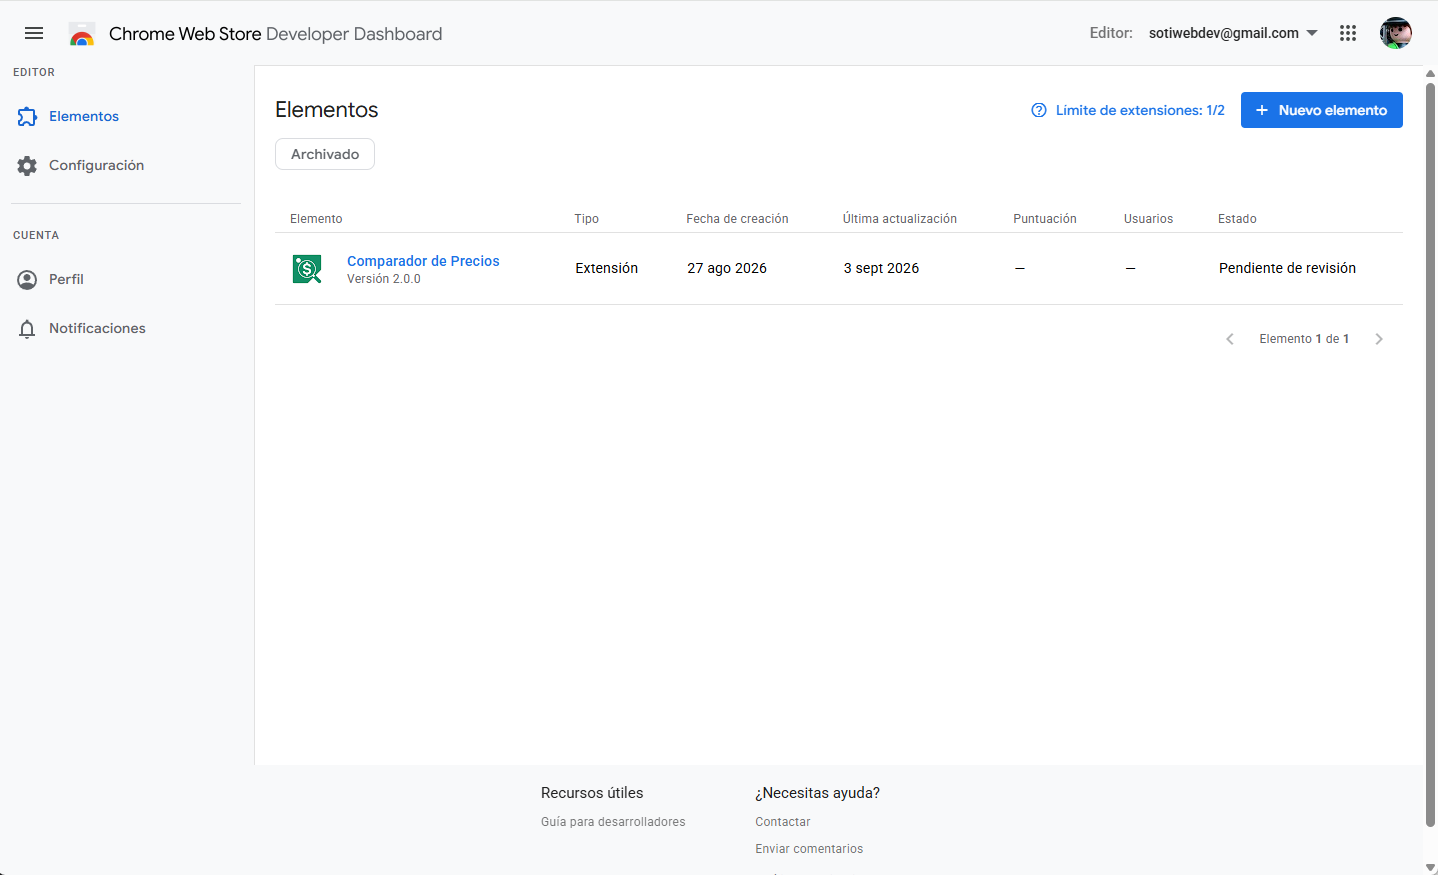
- Preparação para a Chrome Web Store: política de privacidade redigida a partir do código real (não um modelo genérico), descrições da ficha, capturas ajustadas para 1280×800, e justificativa para cada permissão solicitada.
- Primeiro envio para revisão rejeitado pelo Google: a permissão
tabsestava declarada no manifest, mas nenhuma função implementada realmente precisava dela (ver Escalando). Cada uso real dechrome.tabs.*no código foi auditado, confirmando que abrir/fechar abas e ler seu status de carregamento não exigem essa permissão; ela foi removida do manifest, e o app foi reenviado.
Escalando
- V1 → V2: o matching por texto exato quebrava assim que o catálogo real tinha qualquer variação — singular/plural, sinônimos regionais, ou um produto “similar” que a loja retornava em vez de uma lista vazia. A suposição implícita da V1 (o primeiro resultado da loja é o correto) não se sustentava na prática.
- V2 → V3: o matching léxico não distingue conceitos relacionados que não compartilham palavras (kefir vs. iogurte grego). Mas a primeira tentativa de resolver isso com embeddings quase quebrou a precisão já alcançada: um limiar de similaridade permissivo demais deixava passar produtos sem nenhuma relação (um controle de Nintendo Switch foi aceito como resultado de uma busca por pão de forma, com uma pontuação de similaridade tão alta quanto a de correspondências genuínas). Foi preciso redesenhar completamente como os dois sinais se combinam, não apenas ajustar um número.
- Empacotar o modelo de IA: a configuração padrão da biblioteca trazia 4 variantes do runtime WASM pensadas para casos que esta extensão não precisa (WebGPU, compatibilidade com navegadores antigos) — sem essa correção, o pacote final pesaria o dobro do necessário.
- Consistência entre lojas: quando a busca do usuário não especifica tamanho ou variante, cada loja pode escolher — de forma individualmente correta — um produto de um tamanho diferente das demais. Isso não se resolve com melhor matching (não existe um “tamanho correto” objetivo sem mais contexto); foi resolvido com transparência: mostrar o título completo sem truncar e um link direto para a busca real.
- V4 → publicação real: a revisão automática da Chrome Web Store rejeitou o primeiro envio por declarar a permissão
tabssem precisar dela — todo o código que abre, fecha e consulta o status de abas (chrome.tabs.create/remove/.status) funciona sem essa permissão; ela só é necessária se você lêurl,titleoufavIconUrlde uma aba, algo que esta extensão nunca faz, já que as URLs de busca são construídas, não lidas de volta. Foi o único problema real que os testes internos não haviam detectado, porque tudo funcionava igual com ou sem essa permissão a mais — a revisão externa foi o que o tornou visível.
Resultados
| Versão | Período | Resultado | Custo |
|---|---|---|---|
| V1 | Agosto 2026 | Extensão funcional de ponta a ponta, validada manualmente em 7 países e nas plataformas de e-commerce mais comuns da região | $0 — sem servidor próprio |
| V2 | Agosto 2026 | Elimina de forma verificável os falsos positivos “de marca errada” (caso Wong/kefir) sem adicionar nenhuma dependência nova | $0 |
| V3 | Agosto 2026 | Matching semântico rodando 100% no dispositivo do usuário; ~130MB adicionados ao pacote, sem custo de inferência por não depender de nenhuma API de IA de terceiros | $0 recorrente |
| V4 | Agosto 2026 | Ficha, política de privacidade e capturas prontas; primeiro envio rejeitado por uma permissão (tabs) desnecessária, corrigida e reenviada para revisão |
$0 |
Ainda não há métricas de usuários/receita — o produto está em revisão na Chrome Web Store no momento em que este case study foi escrito.
Aprendizados
- Verificar ao vivo antes de confiar na heurística. Cada correção de extração (o formato
AggregateOfferda VTEX, o regex de preços com formatos regionais, o tempo de hidratação de sites em React) veio de inspecionar o DOM real de uma loja, não de presumir um padrão que “deveria” ser cumprido. - Mais “inteligência” não é automaticamente melhor. Adicionar um modelo de embeddings sem validá-lo contra casos reais quase piorou a precisão que já se tinha com uma heurística simples de texto. Um painel de logs mostrando qual sinal decidiu cada resultado foi o que permitiu detectar isso a tempo, em vez de descobrir com usuários reais.
- Perguntar antes de adivinhar evita retrabalho. Toda vez que surgia um dado ambíguo (uma URL de loja que não batia com o país, um texto de produto que podia ser interpretado de duas formas), confirmar antes de presumir saiu mais barato do que desfazer uma decisão tomada às cegas.
- “Sem backend” é uma decisão de produto, não só técnica. Manter tudo local — dados, cache, e até o modelo de IA — simplificou a política de privacidade para algo genuinamente fácil de explicar, eliminou custos recorrentes, e resolveu por design o risco de rejeição por “código remoto” na revisão da Chrome Web Store.
- Transparência é mais barata que precisão perfeita. Quando o matching automático não pode garantir o mesmo tamanho ou variante entre lojas, mostrar o título completo e um link para a busca real da loja resolve melhor o problema do que ajustar o algoritmo indefinidamente.
- Peça só a permissão que seu código realmente usa, não a que “poderia” precisar. A rejeição da Chrome Web Store pela permissão
tabsfoi um lembrete de que declarar permissões a mais “por precaução” não é de graça: além de parecer pior para o usuário, a revisão automática da loja detecta isso e rejeita a publicação. A revisão externa acabou sendo o único teste que expôs esse problema — os testes internos nunca iriam encontrá-lo, porque o código funcionava idêntico com ou sem a permissão extra.