Comparador de precios
Compara el precio de productos en diferentes supermercados.
Ver producto →Resumen rápido
- Rol
- Producto, diseño y desarrollo full-stack (solo)
- Periodo
- Agosto 2026
- Stack técnico
- React + Vite/crxjs + Tailwind (base) → extracción propia (JSON-LD/microdata/DOM) → matching léxico propio → embeddings semánticos locales (ONNX/WASM)
El problema
La idea nació de un recuerdo: cuando mi hijo era pequeño, siempre andábamos buscando ofertas de pañales entre supermercados. En ese momento me hubiera servido muchísimo tener algo así — escribir el producto una sola vez y ver de inmediato dónde estaba más barato, en vez de abrir pestaña por pestaña y repetir la misma búsqueda en cada tienda.
Ese mismo problema sigue vigente hoy, con el agravante de que el buscador de cada tienda no siempre te muestra lo que realmente pediste: cuando no tienen el producto exacto, muchas devuelven “productos similares” en vez de una lista vacía, y es fácil terminar comparando el precio de algo que ni siquiera es lo que buscabas.
La decisión de diseño de fondo fue reducir la complejidad al mínimo posible: nada de scraping periódico de catálogos, nada de infraestructura que mantener, nada de costos que trasladarle al usuario. Todo corre en el propio navegador, bajo demanda, cuando el usuario busca. No es un proyecto pensado para monetizar — es resolver un problema real de la forma más simple y barata posible.
La construcción
Ninguna de estas versiones salió de una planificación cerrada de antemano: cada una salió de probar los resultados reales de la búsqueda, encontrar dónde fallaba la precisión, y ajustar la aplicación en función de eso — no de agregar funcionalidad por agregarla.
V1 — MVP funcional multi-tienda (agosto 2026)
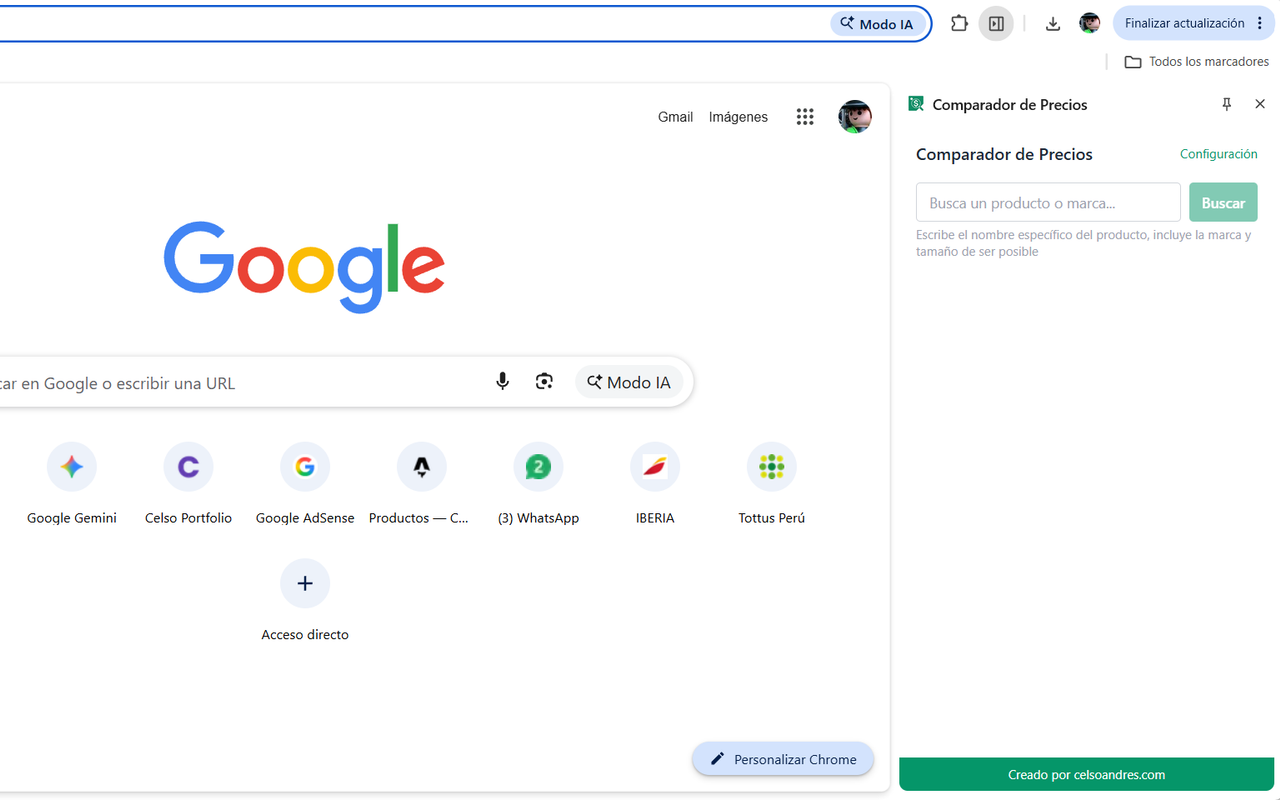
- Manifest V3 completo: service worker en background + interfaz en el side panel de Chrome, sin ningún servidor propio.
- Modelo de datos validado con Zod y CRUD de tiendas persistido en
chrome.storage.local. - Motor de extracción en cascada con puntaje de confianza por estrategia: JSON-LD → microdata → meta tags → heurística de DOM, para cubrir la variedad real de cómo cada plataforma de e-commerce marca sus productos.
- Onboarding guiado (idioma, país, hasta 5 tiendas) con permisos de host solicitados uno por uno, solo para los sitios que el usuario agrega.
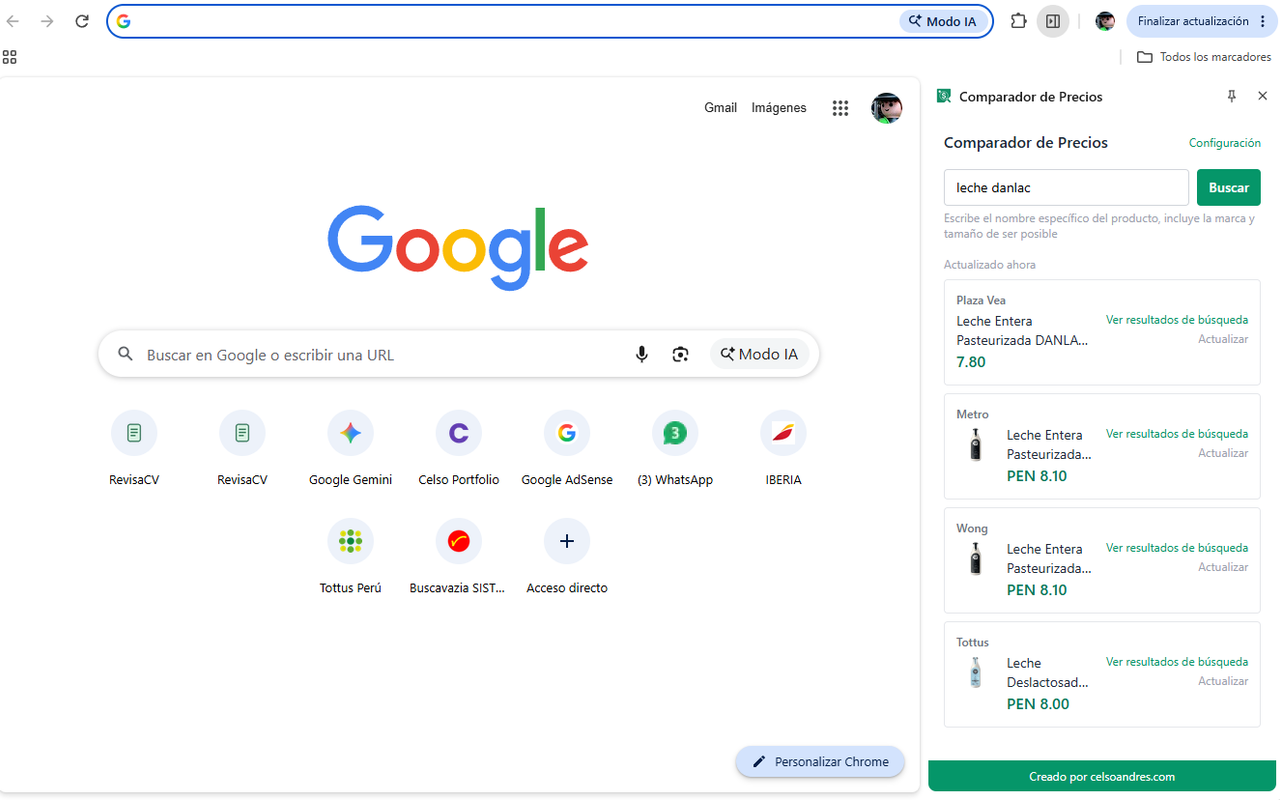
- Orquestación de búsqueda: abre una pestaña (o ventana minimizada) por tienda, extrae, cierra, y cachea el resultado con un TTL configurable.
- Curación manual y verificada en vivo de tiendas sugeridas para 7 países (Perú, Argentina, Chile, Brasil, Paraguay, Colombia, Ecuador) — cada URL de búsqueda confirmada navegando la tienda real, no asumida.
V2 — Matching de relevancia, nivel léxico (agosto 2026)
- Detonante real: una tienda (Wong) devolvió un yogur griego como resultado de una búsqueda de kéfir de una marca específica — la extensión mostraba el primer resultado como si fuera el correcto, sin validar que realmente correspondiera a lo buscado.
- Heurística propia de comparación texto-a-texto: normalización de acentos, tokenización, lista de stopwords en español/portugués, tolerancia a variantes de escritura vía distancia de Levenshtein (singular/plural, typos), sinónimos regionales curados (palta/aguacate, choclo/elote, etc.), y una señal de orden de palabras para desempatar títulos que comparten las mismas palabras pero en distinto orden.
- Nuevo estado “no encontrado” (distinto de “error de extracción”), con un enlace directo a la búsqueda real de la tienda para que el usuario decida si el match automático no le convence.
V3 — Matching semántico local, nivel embeddings (agosto 2026)
- Modelo
multilingual-e5-smallcuantizado (ONNX) corriendo con@huggingface/transformerssobre WebAssembly, empaquetado dentro de la propia extensión — cero llamadas a servicios de IA externos, funciona sin conexión. - Diseñado como señal híbrida, no como reemplazo: el matching léxico sigue siendo el filtro principal (fuerte en nombres de marca, que un modelo de embeddings no distingue bien); el modelo semántico solo interviene en una “zona de duda” del puntaje léxico, con un umbral bastante más exigente del que se probó inicialmente.
- Ajustes de build no triviales para que esto fuera viable: un alias de Vite para evitar empaquetar 4 variantes del binario WASM (hasta 26MB cada una, pensadas para WebGPU/compatibilidad con navegadores viejos que no aplican acá), CSP con
wasm-unsafe-eval, y el modelo vendorizado localmente para cumplir con la política de Manifest V3 contra “código remoto”.
V4 — Confianza del usuario y publicación (agosto 2026)
- Botón de cancelar durante una búsqueda en curso, que corta el proceso y cierra las pestañas abiertas — con un registro de pestañas por búsqueda para cubrir el caso en que Chrome no permite cancelar de verdad una pestaña ya en apertura.
- Transparencia sobre la incertidumbre del matching: el botón “Ver producto” pasó a ser “Ver búsqueda” y enlaza a los resultados reales de la tienda, no a un producto puntual elegido automáticamente.
- Preparación para Chrome Web Store: política de privacidad redactada a partir del código real (no una plantilla genérica), descripciones de ficha, capturas ajustadas a 1280×800, y justificación de cada permiso solicitado.
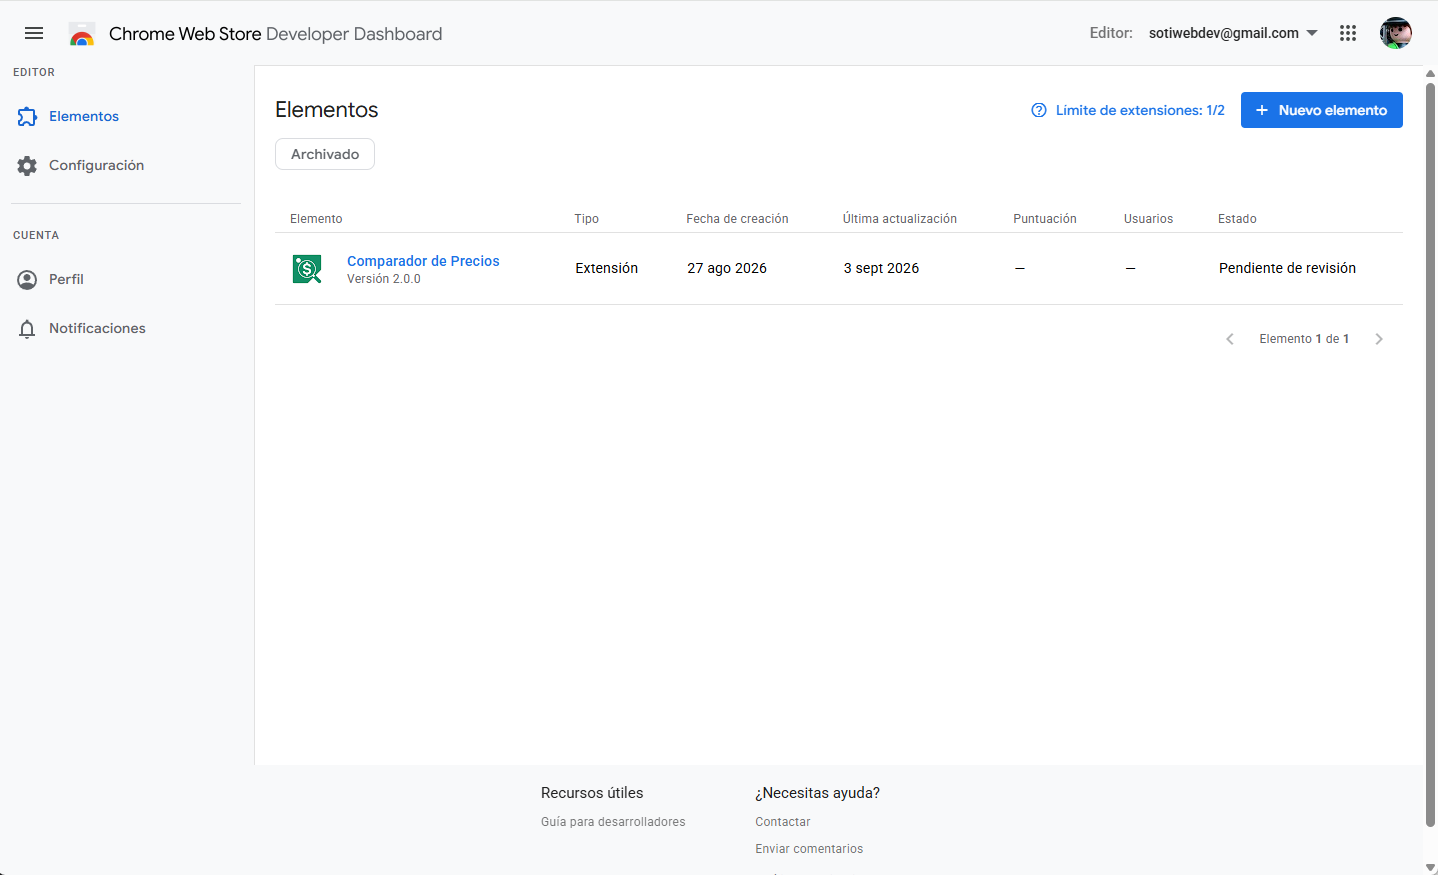
- Primer envío a revisión rechazado por Google: el permiso
tabsestaba declarado en el manifest pero ninguna función implementada lo necesitaba realmente (ver Escalamiento). Se auditó cada uso real dechrome.tabs.*en el código, se confirmó que abrir/cerrar pestañas y leer su estado de carga no requieren ese permiso, se quitó del manifest, y se volvió a enviar.
Escalamiento
- V1 → V2: el matching por texto exacto se rompía apenas el catálogo real tenía cualquier variación — singular/plural, sinónimos regionales, o un producto “similar” que la tienda devolvía en vez de una lista vacía. El supuesto implícito de V1 (el primer resultado de la tienda es el correcto) no se sostenía en la práctica.
- V2 → V3: el matching léxico no distingue conceptos relacionados que no comparten palabras (kéfir vs. yogur griego). Pero el primer intento de resolverlo con embeddings casi rompe la precisión ya lograda: un umbral de similitud demasiado permisivo dejaba pasar productos sin ninguna relación (un control de Nintendo Switch fue aceptado como resultado de una búsqueda de pan de molde, con un puntaje de similitud tan alto como el de coincidencias genuinas). Hubo que rediseñar por completo cómo se combinan las dos señales, no solo ajustar un número.
- Empaquetar el modelo de IA: la configuración por defecto de la librería traía 4 variantes del runtime WASM pensadas para casos que esta extensión no necesita (WebGPU, compatibilidad con navegadores viejos) — sin corregirlo, el paquete final habría pesado el doble de lo necesario.
- Consistencia entre tiendas: cuando la búsqueda del usuario no especifica tamaño o variante, cada tienda puede elegir —de forma individualmente correcta— un producto de un tamaño distinto al de las demás. Esto no se resuelve con mejor matching (no hay una “talla correcta” objetiva sin más contexto); se resolvió con transparencia: mostrar el título completo sin truncar y un enlace directo a la búsqueda real.
- V4 → publicación real: la revisión automática de Chrome Web Store rechazó el primer envío por declarar el permiso
tabssin necesitarlo — todo el código que abre, cierra y consulta el estado de pestañas (chrome.tabs.create/remove/.status) funciona sin ese permiso; solo hace falta si se leeurl,titleofavIconUrlde una pestaña, algo que esta extensión nunca hace porque las URLs de búsqueda se construyen, no se leen de vuelta. Fue el único problema real que las pruebas internas no habían detectado, porque todo funcionaba igual con o sin ese permiso de más — la revisión externa fue la que lo hizo visible.
Resultados
| Versión | Periodo | Resultado | Costo |
|---|---|---|---|
| V1 | Agosto 2026 | Extensión funcional de punta a punta, validada manualmente en 7 países y en las plataformas de e-commerce más comunes de la región | $0 — sin servidor propio |
| V2 | Agosto 2026 | Elimina de forma verificable los falsos positivos “de marca equivocada” (caso Wong/kéfir) sin agregar ninguna dependencia nueva | $0 |
| V3 | Agosto 2026 | Matching semántico corriendo 100% en el dispositivo del usuario; ~130MB agregados al paquete, sin costo de inferencia por no depender de ninguna API de IA de terceros | $0 recurrente |
| V4 | Agosto 2026 | Ficha, política de privacidad y capturas listas; primer envío rechazado por un permiso (tabs) innecesario, corregido y reenviado a revisión |
$0 |
No hay métricas de usuarios/ingresos todavía — el producto está en revisión de Chrome Web Store al momento de escribir este case study.
Aprendizajes
- Verificar en vivo antes de confiar en la heurística. Cada arreglo de extracción (el formato
AggregateOfferde VTEX, el regex de precios con formatos regionales, el tiempo de hidratación de sitios React) salió de inspeccionar el DOM real de una tienda, no de asumir un estándar que “debería” cumplirse. - Más “inteligencia” no es automáticamente mejor. Agregar un modelo de embeddings sin validarlo contra casos reales estuvo a punto de empeorar la precisión que ya se tenía con una heurística simple de texto. Un panel de logs mostrando qué señal decidió cada resultado fue lo que permitió detectarlo a tiempo, en vez de descubrirlo con usuarios reales.
- Preguntar antes de adivinar evita retrabajo. Cada vez que apareció un dato ambiguo (una URL de tienda que no cuadraba con el país, un texto de producto que podía interpretarse de dos formas), confirmar antes de asumir salió más barato que deshacer una decisión tomada a ciegas.
- “Sin backend” es una decisión de producto, no solo técnica. Mantener todo local —datos, caché, y hasta el modelo de IA— simplificó la política de privacidad a algo genuinamente simple de explicar, eliminó costos recurrentes, y resolvió por diseño el riesgo de rechazo por “código remoto” en la revisión de Chrome Web Store.
- La transparencia es más barata que la precisión perfecta. Cuando el matching automático no puede garantizar el mismo tamaño o variante entre tiendas, mostrar el título completo y un enlace a la búsqueda real de la tienda resuelve mejor el problema que seguir afinando el algoritmo indefinidamente.
- Pide solo el permiso que tu código realmente usa, no el que “podría” necesitar. El rechazo de Chrome Web Store por el permiso
tabsfue un recordatorio de que declarar permisos de más “por si acaso” no es gratis: además de verse peor para el usuario, la revisión automática de la tienda lo detecta y rechaza la publicación. La revisión externa terminó siendo la única prueba que expuso ese problema — las pruebas internas nunca lo iban a encontrar porque el código funcionaba idéntico con o sin el permiso de más.